
In twee uur van idee naar resultaat
Ik wil je even meenemen in een wat eigenaardig hobbyproject dat aantoont hoe ingrijpend de wereld veranderd is. Op een luilekkere zondag kon ik, met behulp van ChatGPT en Claude, van idee naar een werkend resultaat gaan: een app die deed wat ik wou. Het kostte me slechts twee uur. Vroeger zou het verschillende weekends aan onderzoek, probeersels en herzieningen gekost hebben. Of, waarschijnlijker, was ik nooit verder gekomen dan de allereerste stapjes, omdat mijn interesse ondertussen bekoeld zou zijn.
Een F1-pronostiek
Er was een tijd dat ik elke sportwedstrijd bekeek, maar tegenwoordig volg ik enkel Formule 1 enigszins van dichtbij. Toen er een pronostiekwedstrijd werd georganiseerd via Bluesky besloot ik deel te nemen. Wie kan een prijzenpot weerstaan die volledig bestaat uit het recht om op te scheppen?
De regels voor de wedstrijd zijn eenvoudig:
- De organisator bepaalt voor elk raceweekend de kost van de piloten. De deadline voor het indienen is de start van de kwalificaties.
- Je kiest exact tien piloten binnen het voorziene budget.
- Je verdient punten voor hun positie in kwalificaties, sprint races en de race zelf.
- Je kan extra punten verdienen door de piloot met de snelste ronde en het team met de snelste pitstop te voorspellen.
Na een zeer middelmatig seizoen bevond mijn team zich plots in polepositie voor de GP in Mexico City. Natuurlijk wil ik dan tijdens de race live kunnen zien of die positie behouden kan blijven.
Belangrijk om te weten: ik wist al dat er tools bestonden waarmee je de live data van de F1 servers kan ophalen. Dit idee was waarschijnlijk nooit in mijn hoofd gekomen als dat niet zo was. Maar daardoor ging ik ook al meteen zeer specifieke dingen (laten) uitzoeken, wat me op het einde van de rit meer tijd gekost heeft.
Na de conceptuele fase en research van een half uur, heb ik anderhalf uur gespendeerd aan instructies geven, resultaten verifiëren en een UI ontwerpen die me wat aanstond. Ik neem je mee door de verschillende stappen die ik heb gezet. Daarin wordt het hier en daar technisch. De lessen die je hieruit kan trekken zijn dat niet. Je vindt ze helemaal onderaan.
Ronde 1
Mijn aanpak stond al redelijk vast. De kern zou bestaan uit een webapplicatie, bovenop het Django-framework, die de volgende gegevens gebruikt:
- De deelnemers en hun picks voor de Grand Prix (gekozen piloten, snelste ronde en snelste pitstop).
- De meest recente posities van piloten in de race.
- De regels voor de toekenning van punten binnen de pronostiek.
Voeg dit samen en je hebt een up-to-date beeld van hoe iedereen er op dat moment voor staat in de Grand Prix.
De puntentoewijzing van de pronostiek omzetten in code is eenvoudig. Net als het achterhalen van de picks van de andere deelnemers. De organisator publiceert na de deadline immers een lijst van alle deelnemers en wie ze gekozen hebben. Het volstaat om die pagina op te halen, de gegevens eruit te halen en in de database te stoppen voor verder gebruik tijdens de racesessie.
De bestaande "F1-toolkit" zou dan instaan voor het ophalen van de live posities in de race, en de snelste ronde en pitstop, met een laagje errond dat die gegevens in de database bijwerkt. De live feed zou net zo gemakkelijk vervangen moeten kunnen worden door historische data om een race te simuleren.
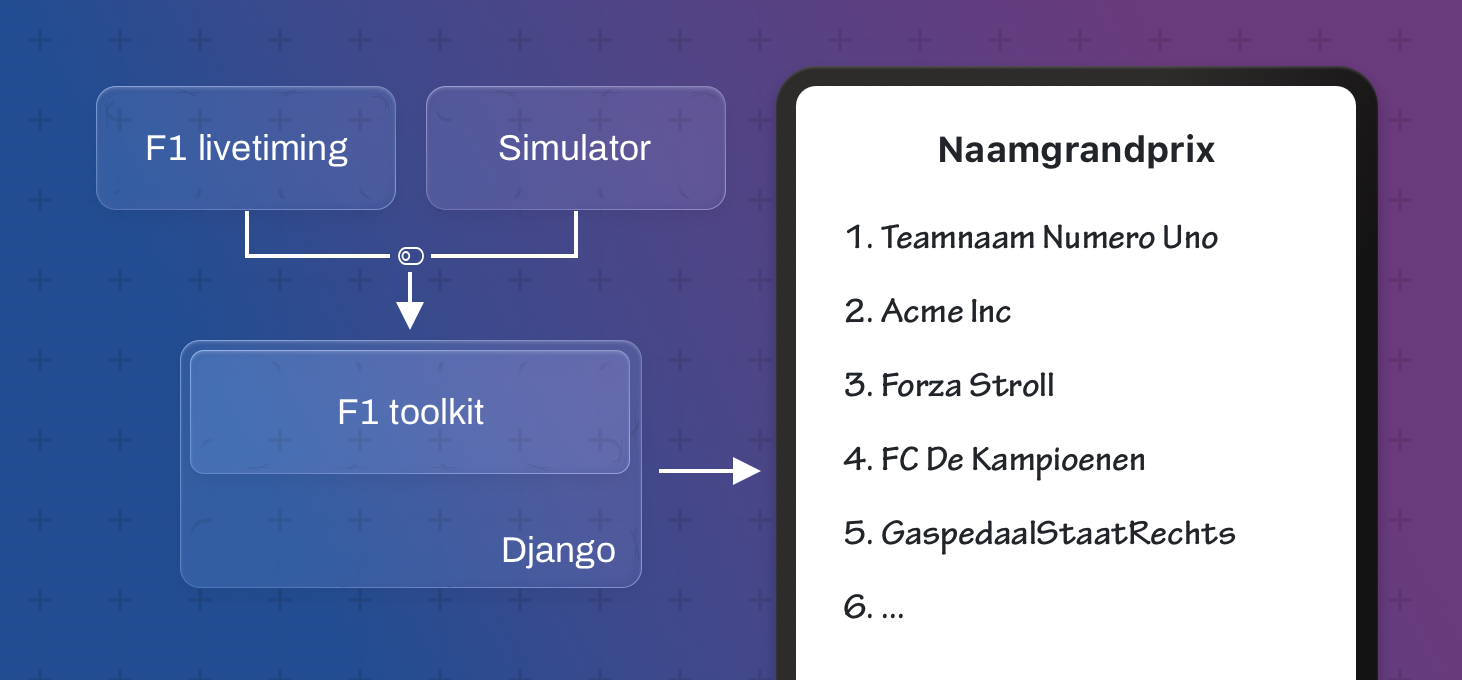
Bepalen welke F1-toolkit we zouden gebruiken, was wat complexer. Met de hulp van ChatGPT werden verschillende opties gevonden en afgewogen. Sommige vereisten bijvoorbeeld een abonnement op een aparte service, terwijl ik gewoon mijn bestaande F1TV-abonnement wilde gebruiken. De documentatie van de ene ging meer in op de technische architectuur van de code dan op het gebruik ervan. De andere kon dan weer enkel met historische data uit vorige races werken. Met andere woorden: geen live feed.
Kunnen kiezen of data uit de live race, dan wel een gesimuleerde versie kwam, was een absolute vereiste. Het is de enige manier om een goed en enigszins betrouwbaar resultaat te krijgen zonder tijdens de race te liggen diagnosticeren en programmeren, met een half oog op de televisie.
Undercut leek alles af te vinken. Het kan werken met data uit vorige Grote Prijzen en die ook live aanleveren. Het is echter geschreven in .NET, waar ik weinig ervaring mee heb, en het is vooral een interface bovenop de data. Ik heb de data zelf nodig. Om het te laten doen wat ik nodig had, zouden we aan de slag moeten met de code van Undercut, die tweaken en een eigen versie bouwen. Dat vormt geen grote uitdaging meer in tijden van LLM's, maar de feedbackcyclus zou te lang worden om snel resultaat te krijgen. Code tweaken, builden, testen, repeat. Ik verkies Python voor dagdagelijks werk, net omdat ik wijzigingen snel kan evalueren.
De keuze viel daarom finaal op LiveF1, ook al was dat enkel bestemd voor live data. Dan bouwen we de simulator toch gewoon zelf? In essentie doet die niets meer dan op gezette tijdstippen data uitspuwen.
Ronde 2
Omdat ik nu zelf een laag moest bouwen die gesimuleerde data kon aanleveren alsof het live was, besloot ik de applicatie op te delen. Enerzijds de webapp, anderzijds de feed app (genaamd ff1) die zelfstandig draait en de data in een eigen protocol aanlevert aan de webapp, "zoals die binnenkomt".
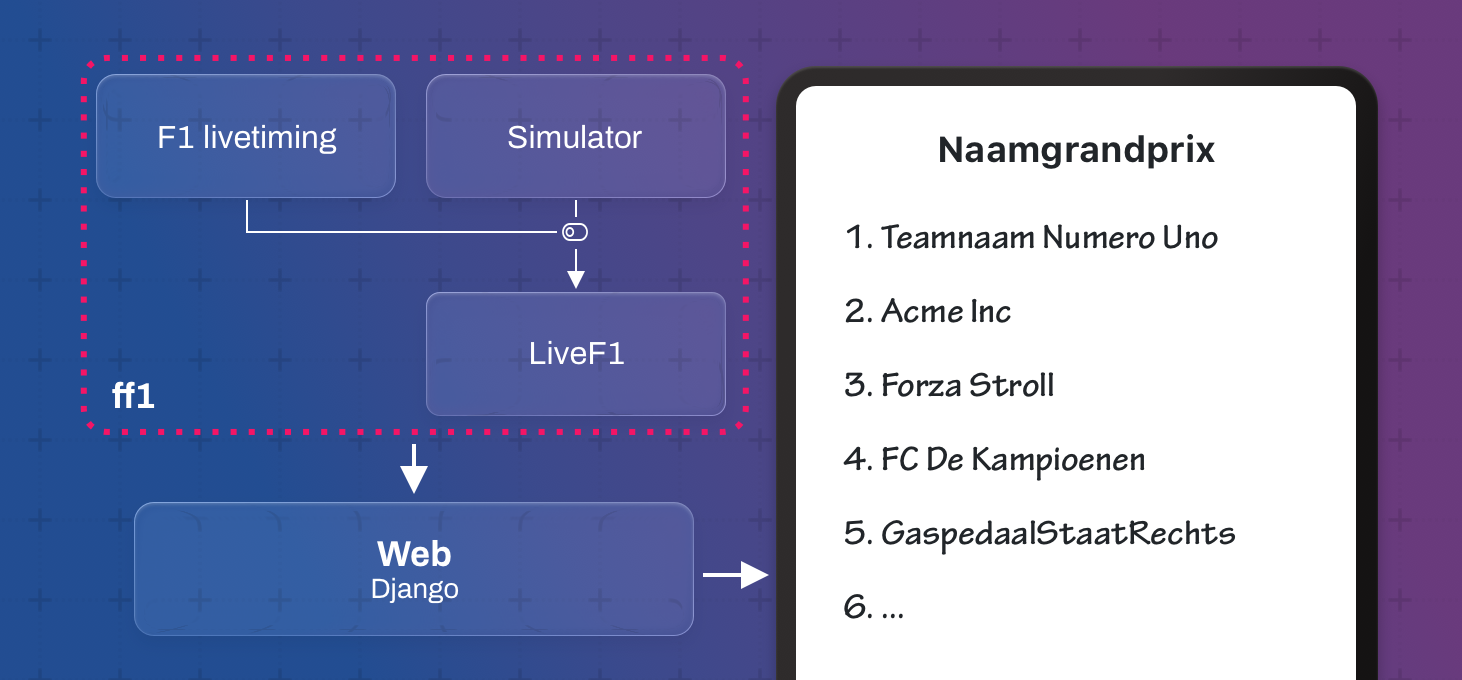
Deze aanpak heeft een aantal voordelen. Zo beperk je de complexiteit van de feed tot een kleiner oppervlak. Het eigen protocol bevat exact de data die we nodig hebben. Niets meer, niets minder.
Belangrijker: enkel ff1 moet over mijn gebruikersnaam en wachtwoord voor F1TV beschikken. Een exploit of foute configuratie van de webapp leidt er dus niet automatisch toe dat mijn credentials op straat liggen.
Bovendien kan ik ff1 stoppen en starten naar believen. Of zelfs automatisch laten stoppen een aantal minuten nadat de finish bereikt werd.
Ronde 3
Met Docker prop je applicaties in een zogenaamde image, met daarbij alles wat nodig is om de applicatie uit te voeren. Zorg ervoor dat Docker draait, download de image en start een "container" op basis van die image en je bent klaar. Je hoeft niet voor elk project extra's op de server zelf te installeren.
Tot nu toe ging ik ervan uit dat ik deze applicaties in Docker zou draaien. Zo werkt in feite alles op mijn servers. Aangezien deze toepassingen enkel tijdens de race nuttig zijn en het bouwen van Docker images altijd wat tijd kost, koos ik halverwege voor een eenvoudigere oplossing: executable files met behulp van uv.
Het concept:
- Je hebt een Python file
- Je maakt die executable door de juiste info bovenaan de file toe te voegen, inclusief een verwijzing naar de dependencies die je nodig hebt.
- Je runt die file via uv, die een geïsoleerde omgeving voorziet waarin de dependencies automatisch geïnstalleerd worden.
Het enige probleem: Django vereist net wat meer opzet om dit te realiseren. Toen besefte ik dat ik meteen in het diepe was gesprongen. We hadden Django helemaal niet nodig. We hadden geen database nodig. We hadden enkel een eenvoudig proces nodig dat alles inlaadt en in het geheugen houdt. Dat kan perfect, want het aantal bezoekers is erg beperkt (zijnde: ik).
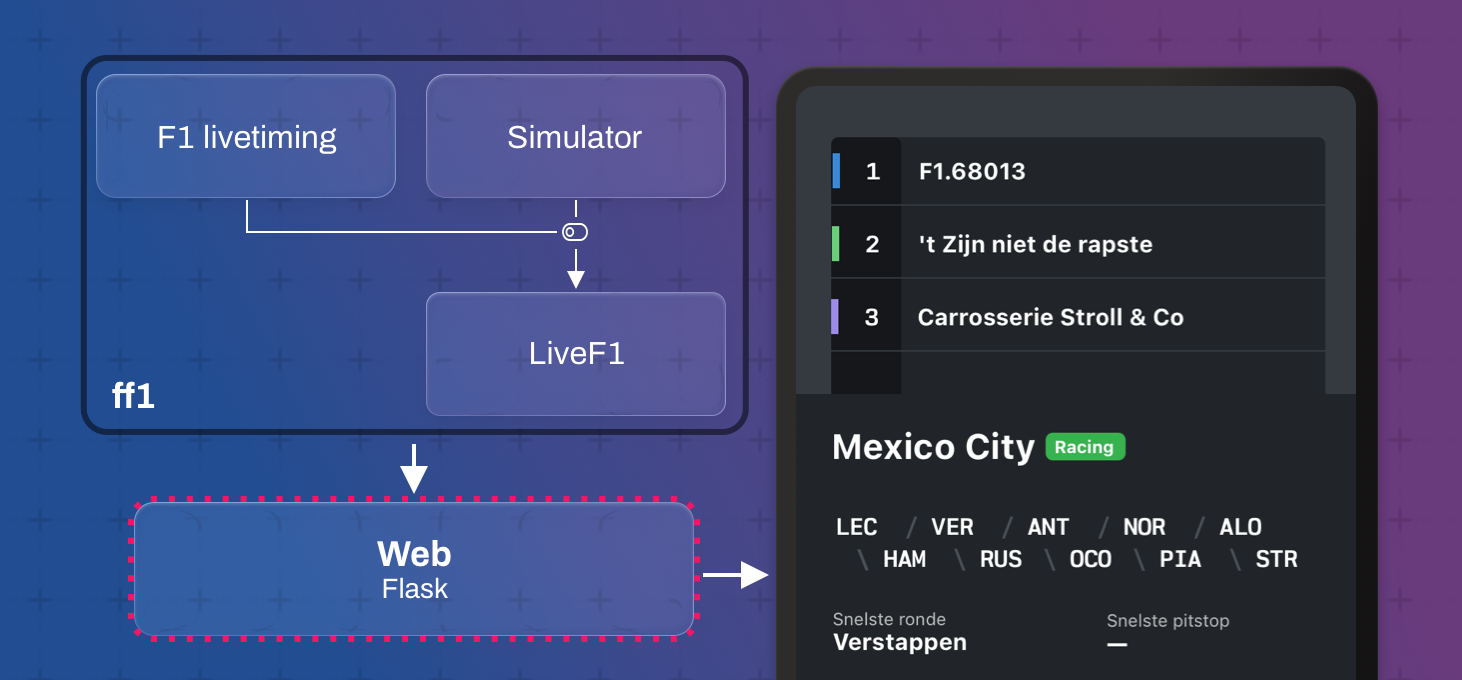
De webapp werd dus volledig getransformeerd. Van Django naar Flask. Van een database naar JSON files met informatie over de teams, piloten, deelnemers en hun selecties.
Terwijl de Claude Code agent net niet mopperde vanwege weer een volledige ommezwaai, ging ik aan de slag met hoe het er moest uitzien.
Ronde 4
De prerace-uitzending van F1TV was ondertussen gestart. Met behulp van de reeds opgehaalde data van de vorige Grote Prijs in Austin werden bugs geëlimineerd, werden overbodige constructies gestript en werd de interface verfijnd.
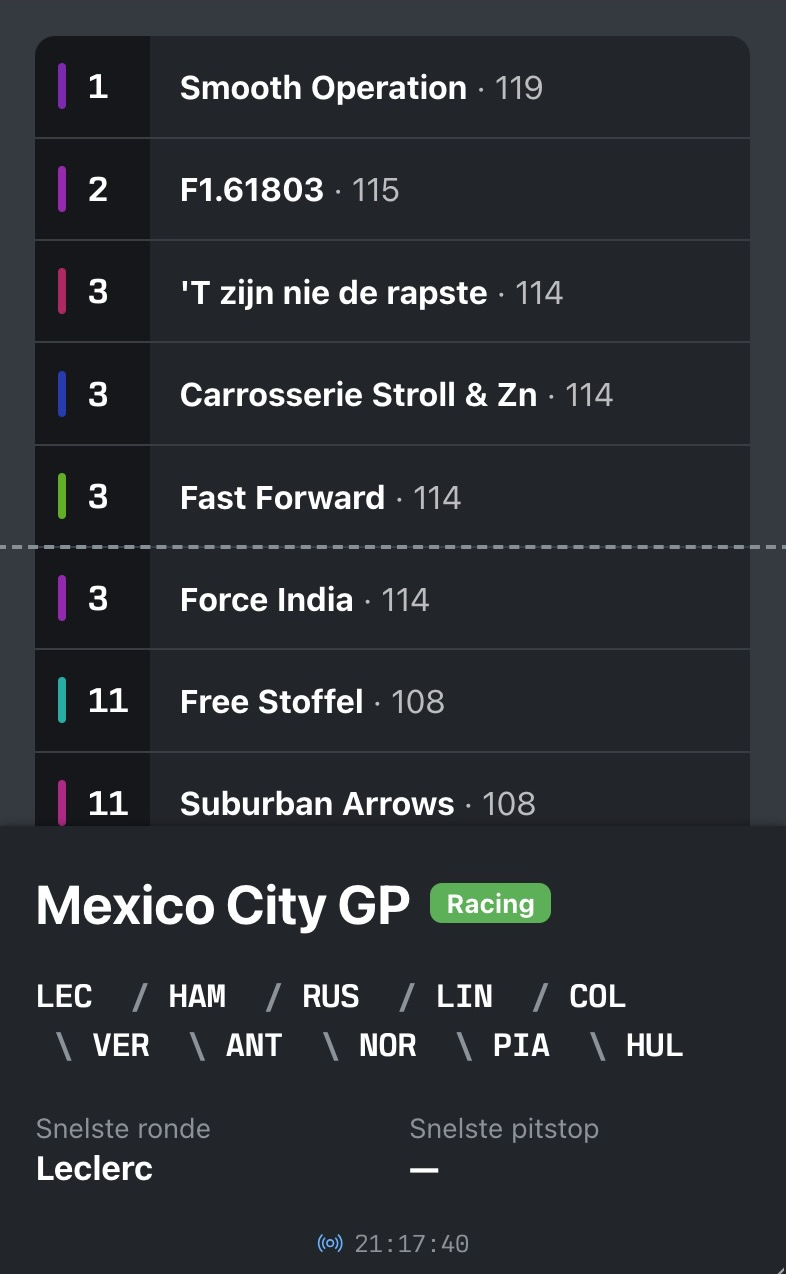
Klaar voor de race in Mexico City. Die bleek de perfecte gelegenheid om de werking te verifiëren. Een virtual safety car, een complete safety car en zelfs een rode vlag passeerden de revue.
Op een bepaald moment dacht ik dat ik een vreemde bug had gevonden. De interface gaf aan dat Russell in de pitstraat was, terwijl ik hem op de stream van F1TV gewoon zag rondrijden. Althans tot hij een dertigtal seconden later ook werkelijk de pit indook. De live stand van de app was sneller dan het beeld dat ik voor me zag.
Het enige dat we uiteindelijk niet konden realiseren was de snelste pitstop. De F1 livetiming blijkt enkel de totale tijd in de pitstraat aan te bieden en niet hoe lang de pitstop zelf duurde.
Waar eindigde mijn team uiteindelijk? Zoals de rest van het seizoen: in het midden.
Lessen
Neem niets aan
Het beeld van de architectuur voor de software was in mijn hoofd al redelijk helder voordat ik echt begon te onderzoeken. Als ik dat achterwege had gelaten, was ik sneller tot een beter eindresultaat gekomen. Durf een stapje terug te zetten en een niveau hoger te beginnen.
Daarnaast blijft het essentieel om de informatie, die je door LLM's voorgeschoteld krijgt, te verifiëren. Zij kunnen helpen om een strategie op te stellen en je te gidsen. Jij bent nog steeds de piloot. Jij weet wat er werkelijk moet gebeuren.
Van aanpak veranderen is goedkoop
Tegelijkertijd is het nog nooit zo gemakkelijk geweest om een andere aanpak te onderzoeken en uit te proberen.
Let wel: coding agents houden van automatische testen, zodat ze kunnen verifiëren dat ze niets naar de knoppen hebben geholpen. Zorg ervoor dat je in zulke fases focust op systeemtesten, die vooral de werking aan de buitenkant toetsen aan je vereisten. Testen op een lager niveau zijn nuttig, maar evenzeer een hinderpaal wanneer je dat lagere niveau compleet wil reviseren.
Maak je doelstellingen duidelijk
De agents/models gaan erg vaak overengineeren. Het kleinst mogelijke gaatje dat bestaat willen ze gaan vullen met extra code om het op te vangen.
Dat is sowieso vaak overbodig; alles gewoon laten crashen kan wel eens beter zijn dan proberen om te gaan met de oorzaak. In dit geval is het zelfs totaal ongewenst: ik wil het simpel, rechttoe rechtaan. Het is volledig voor eigen gebruik. Het komt niet op het publieke internet. Er zijn geen twintig parallelle processen. Alles wat "not done" is voor echte applicaties zorgde hier voor een stevige vereenvoudiging.
Laat dus expliciet weten wat je verwacht en welke condities niet relevant zijn voor jouw resultaat. Ik heb Claude ook moeten vertellen te stoppen met focussen op "hoeveel tijd we nog hadden" voor de race begon.
Prototypes zijn beter dan plannen op papier
Je weet pas wat kan als je het omzet in code, in iets dat werkt. Dat moet niet perfect zijn, verre van, maar eens je ermee kan spelen, kan kijken wat er gebeurt, krijg je meer informatie. Beperkingen worden duidelijker. Mogelijkheden worden helderder.
Software schrijven is simpel
Je hebt met de juiste tools en budgetten geen programmeur meer nodig.
Die zin snijdt diep in mijn ziel. Het bedenken, schrijven en verfijnen van regels code, van Python tot en met CSS, om het resultaat te verkrijgen dat ik zocht... dat was mijn zaligheid.
De realiteit is dat dit zo simpel geworden is, dat de belangrijkste vereisten om tot een goed functionerend en veilig programma te komen, neerkomen op achtergrondkennis. LLM's zullen je met plezier een programma maken waarvoor je belachelijk veel infrastructuur nodig hebt. Of, als je wat tegenwerkt, je met even veel plezier volgen naar de andere kant en absolute essentials gaan weglaten.
De kern: ze werken ofwel op basis van de grote implementaties waarop ze getraind werden, met allerlei toeters en bellen die jij niet nodig hebt, ofwel proberen ze te doen wat jij wil. Beide vereisen dat jij weet waar de grenzen liggen. Ik weet waar ze liggen, of waar ik ze zelf moet plaatsen. En ik weet wanneer ik het niet weet. Ik heb jarenlange ervaring in het maken van software, en dat omvat meer dan "programmeren".
Ga je hier zelf mee aan de slag zonder die ervaring, wees dan dubbel zo voorzichtig.